ENEY.CLOUD 데이터바우처 · 클라우드바우처 · 스마트서비스 · 모두의 창업 바우처 공급사업자 선정GS인증 기사 보기 →
알림 대시보드를 통해 CPU, 메모리, 디스크, 네트워크 등의 임계값을 설정하고, 해당 값을 초과할 때 이메일로 알림을 받을 수 있습니다. 인스턴스와 컨테이너(Pod) 모두에 적용 가능하며, 조직 전체에 적용되는 Global 설정과 개별 리소스별 커스텀 설정을 함께 관리할 수 있습니다.
| 특징 | 설명 |
|---|---|
| 이메일 알림 | 임계값 초과 시 설정한 이메일로 알림 수신 |
| Global 설정 | 모든 리소스(인스턴스, Pod)에 적용되는 기본 임계값 |
| 커스텀 설정 | 개별 리소스(인스턴스, Pod)별 맞춤형 임계값 설정 |
| 상태 표시 | Global → Custom으로 상태 변경 추적 |
| 개별 관리 | 각 리소스(인스턴스, Pod)별 독립적인 알림 설정 가능 |
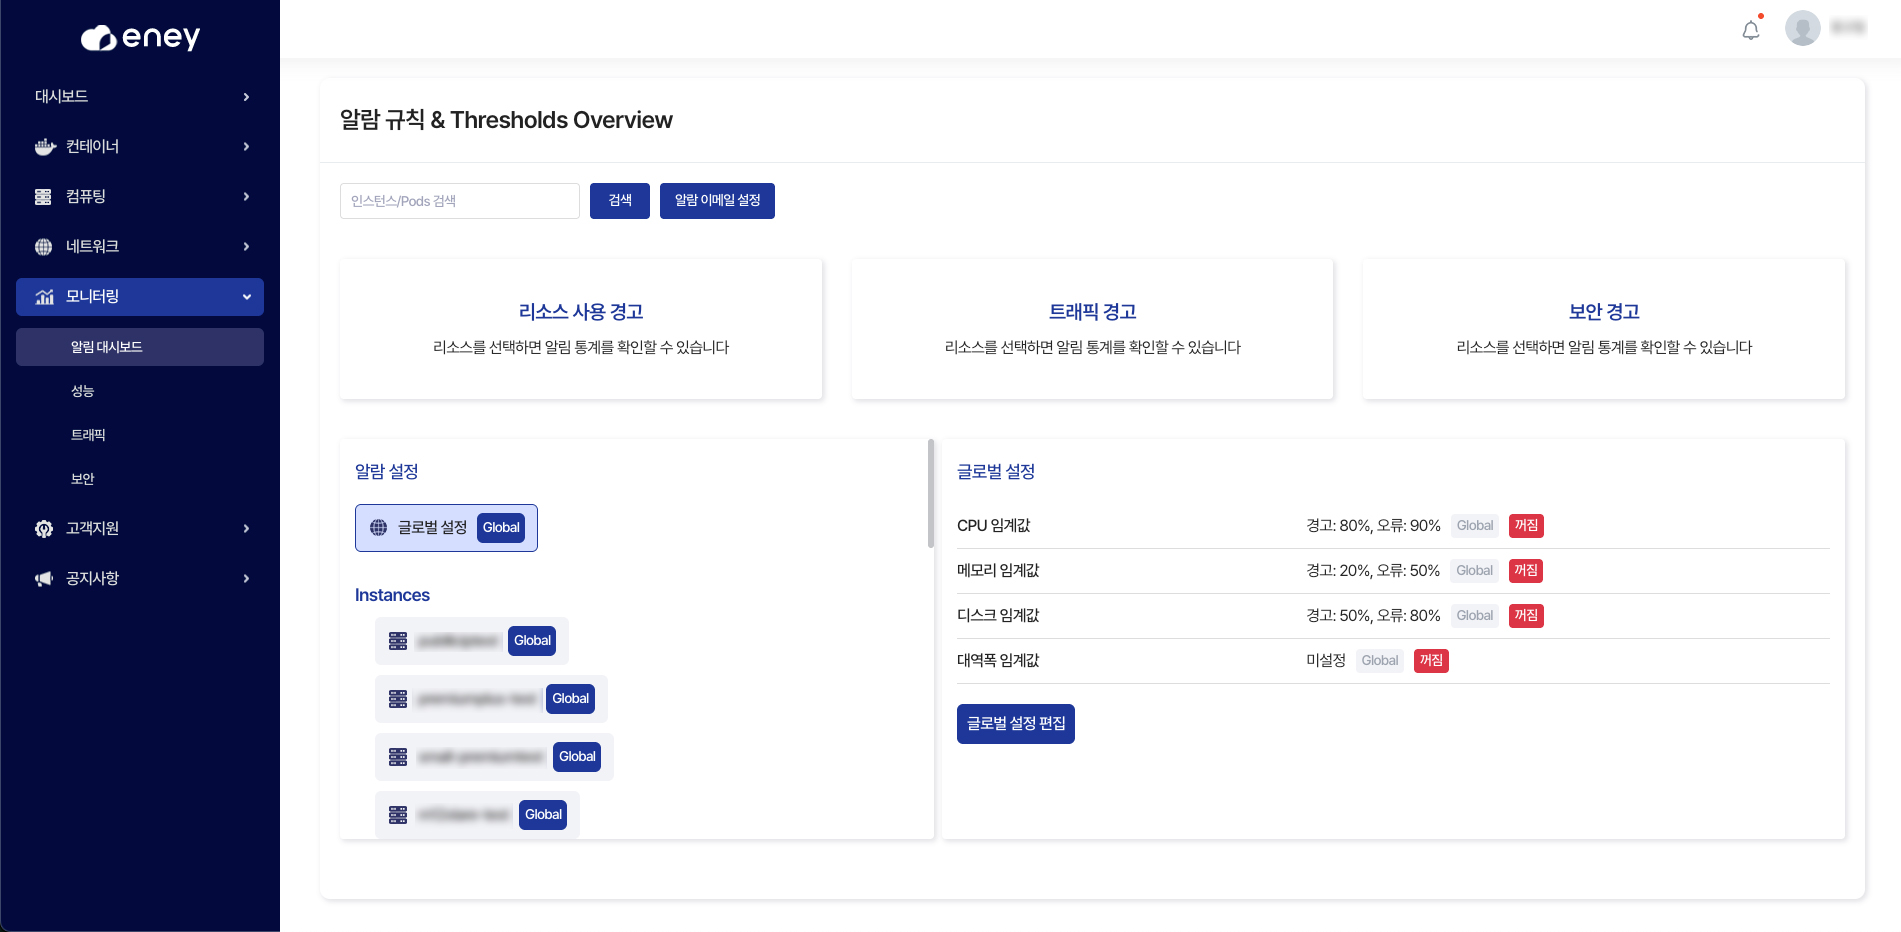
알림 대시보드 페이지는 다음과 같이 구성되어 있습니다:
페이지의 상단에는 3가지 알림 경고 정보가 카드 형태로 표시됩니다:
| 카드 | 설명 |
|---|---|
| 리소스 사용 경고 | 리소스 사용량이 설정된 임계값을 초과한 상태 |
| 트래픽 경고 | 네트워크 트래픽이 설정된 임계값을 초과한 상태 |
| 보안 경고 | 보안 이벤트(공격 시도, 이상 접근 등) 감지 상태 |
각 카드의 설명:
글로벌 설정 (Global):
Instances 섹션:
개별 인스턴스들이 리스트 형태로 표시됩니다:
| 리소스 | 상태 |
|---|---|
| publiciptest | Global |
| premiumplus-test | Global |
| small-premiumtest | Global |
| m12ixlare-test | Global |
Pods 섹션:
개별 컨테이너(Pod)들이 리스트 형태로 표시됩니다:
| 리소스 | 상태 |
|---|---|
| tweq53 | Global |
| cpu3gput | Global |
| cpu1gput | Global |
| ter3423 | Global |
상태 표시:
우측 상단에 현재 적용되는 임계값을 요약으로 표시합니다:
| 항목 | 값 |
|---|---|
| CPU 임계값 | 경고: 80%, 오류: 90% |
| 메모리 임계값 | 경고: 20%, 오류: 50% |
| 디스크 임계값 | 경고: 50%, 오류: 80% |
| 네트워크 임계값 | 미설정 |
설정 수정 버튼: "글로벌 설정 변경"
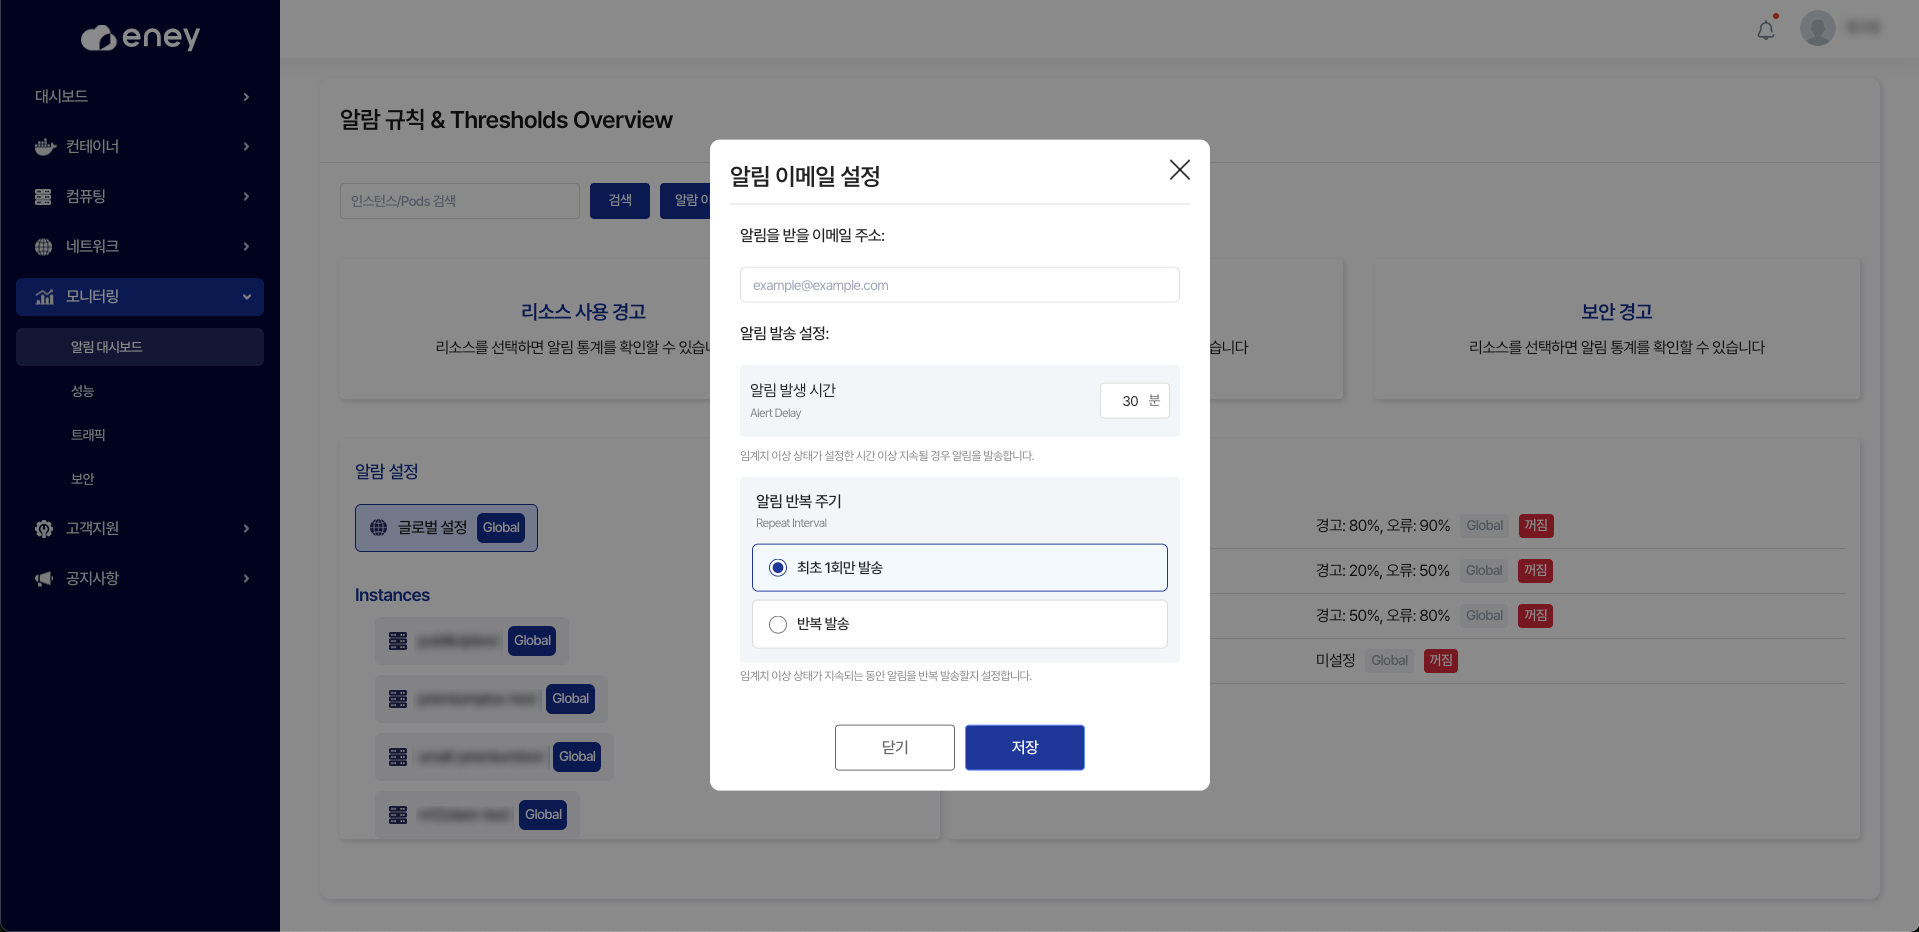
필드: 알림을 받을 이메일 주소
bh7370608@eney.co.kr필드 1: 체크 간격
필드 2: 최대 발송 횟수
설정 예시:
체크 간격: 5분
최대 발송 횟수: 1회

→ 매 5분마다 임계값을 확인하고,
  임계값 초과 시 1번만 이메일 발송
Global 설정의 특징:
토글: 활성화/비활성화
경고 임계값 (Warning):
오류 임계값 (Critical):
사용 사례:
CPU 사용률 모니터링
- 경고: 80% → 서버 점검 필요
- 오류: 90% → 즉시 조치 필요
토글: 활성화/비활성화
경고 임계값 (Warning):
오류 임계값 (Critical):
사용 사례:
메모리 사용량 모니터링 (남은 메모리 기준)
- 경고: 20% → 메모리 가용률 낮음
- 오류: 50% → 즉시 메모리 확보 필요
토글: 활성화/비활성화
경고 임계값 (Warning):
오류 임계값 (Critical):
사용 사례:
디스크 용량 모니터링
- 경고: 50% → 디스크 정리 계획 필요
- 오류: 80% → 긴급히 디스크 확보
토글: 활성화/비활성화
경고 임계값 (Warning):
오류 임계값 (Critical):
사용 사례:
네트워크 트래픽 모니터링
- 경고: 500 Mbps → 트래픽 증가 추세 감시
- 오류: 900 Mbps → 대역폭 확충 검토
커스텀 설정의 특징:
또는:
개별 인스턴스의 커스텀 설정은 Global 설정과 동일한 항목을 포함합니다:
프로덕션 서버 (publiciptest) - 인스턴스:
Global 설정 사용
- CPU 경고: 80%, 오류: 90%
- 메모리 경고: 20%, 오류: 50%
- 디스크 경고: 50%, 오류: 80%
개발 서버 (small-premiumtest) - 인스턴스:
커스텀 설정 적용
- CPU 경고: 85%, 오류: 95% (더 관대함)
- 메모리 경고: 10%, 오류: 30% (더 엄격함)
- 디스크 경고: 60%, 오류: 90% (더 관대함)
상태:
프로덕션 컨테이너 (cpu3gput) - Pod:
Global 설정 사용
- CPU 경고: 80%, 오류: 90%
- 메모리 경고: 20%, 오류: 50%
테스트 컨테이너 (cpu1gput) - Pod:
커스텀 설정 적용
- CPU 경고: 85%, 오류: 95%
- 메모리 경고: 30%, 오류: 70%
상태:
웹 서버 (premiumplus-test - 인스턴스, tweq53 - Pod):
Global 설정에서 커스텀 설정으로 변경:
기존 Global 설정:
- 네트워크 경고: 500 Mbps
- 네트워크 오류: 900 Mbps

새로운 커스텀 설정:
- 네트워크 경고: 1000 Mbps (더 높음)
- 네트워크 오류: 1500 Mbps (더 높음)

이유: 웹 서버는 트래픽이 많기 때문에
      더 높은 임계값에서 알림 필요
알림 이메일 설정:
- 이메일: admin@company.com, ops@company.com
- 체크 간격: 5분 (매 5분마다 확인)
- 최대 발송 횟수: 1회

동작:
→ 매 5분마다 모든 인스턴스 상태 확인
→ 임계값 초과 시 1회만 이메일 발송
→ 정상으로 돌아올 때까지 재알림 없음
| 상황 | 알림 |
|---|---|
| 경고 임계값(Warning) 초과 | ⚠️ 경고 알림 발송 |
| 오류 임계값(Critical) 초과 | 🔴 오류 알림 발송 |
| 정상 범위 복귀 | ✓ 정상 복귀 알림 |
예상 알림 이메일:
[에네이클라우드] ⚠️ 경고 알림

인스턴스: publiciptest
항목: CPU 사용률
현재값: 85%
임계값: 80% (경고), 90% (오류)
발생시간: 2026-04-27 10:30:00
상태: 경고

조치 사항:
- 서버의 CPU 사용률을 확인하세요.
- 불필요한 프로세스 종료 검토
- 필요시 인스턴스 업그레이드 검토
Global은 모든 리소스(인스턴스, Pod)에 적용되는 기본 임계값이고, Custom은 개별 리소스별로 다르게 설정한 임계값입니다. Custom 설정이 있는 리소스는 Global 설정을 무시하고 Custom 설정이 적용됩니다.
네, Custom 설정에서 [Global로 복귀] 버튼을 클릭하면 다시 Global 설정으로 돌아갑니다.
네, 쉼표(,)로 구분하여 여러 이메일을 등록할 수 있습니다. (예: admin@company.com, ops@company.com)
이메일 설정에서 "최대 발송 횟수"를 줄이거나, 임계값을 조정하세요. 또는 "체크 간격"을 늘려서 확인 빈도를 줄일 수 있습니다.
해당 리소스의 Custom 설정을 변경하세요. 다른 리소스는 Global 설정으로 유지됩니다.
경고는 주의가 필요한 수준이고, 오류는 즉시 조치가 필요한 심각한 수준입니다. 두 임계값 모두 이메일 알림을 발송합니다.